R1 全面就绪 · 显式代码重构推理
DeepSeek - 探索未至之境

探索认知未至之境 DeepSeek 官方入口

欢迎访问 DeepSeek官网 代码工程推理专区。本站全面打通 DeepSeek网页版入口 在线无感交互、DeepSeek api开放平台 毫秒级并发调度,以及完全开源的 DeepSeek Harness 离线双盲语法树评测沙箱,助您直达系统级代码重构、架构解耦与企业级软件生产阵地。
DEEPSEEK_REASONING_CONSOLE.SH
REFACTOR_ENGINE // ACTIVE
DeepSeek 官方代码重构控制台界面预览图
> R1_ENGINE: REASONING_CHAIN_DEPTH = 128K
> AST_VERIFY: PASS@1 = 79.8%
> INVERTED_TAIL_CANVAS: ACTIVE_TEAL
TECHNICAL SPECIFICATIONS

核心算力架构与代码工程推理突破

基于 DeepSeek 团队自主研发的基础模型算法栈,以高效多头潜在注意力压缩与大规模强化学习重塑软件架构理解效率。

SPEC // 01 KV 压缩

MLA 多头潜在注意力

自研 Multi-Head Latent Attention 机制,将推理时键值缓存显存占用压缩至传统架构的 17%,以极少硬件开销支撑全工程代码上下文并发吞吐。

显存压缩比 5.88x
SPEC // 02 自主反思

纯强化学习驱动

摆脱传统人工标注代码对错冷启动依赖,模型在纯 RL 奖励信号指引下自主涌现语法树边界校验、因式解耦与死锁反思重构能力。

标注样本依赖 0 Tokens
SPEC // 03 细粒度稀疏

256 专家 MoE 路由

拥有 6710 亿总参数,每次 Token 前向计算仅动态激活 370 亿参数,结合无辅助损失负载均衡机制,实现顶级代码综合分析与经济效能兼得。

激活参数占比 5.5%
SPEC // 04 长程上下文

128K 超长显式推理

原生支持 128,000 Tokens 长窗口,无论是跨数十个单体模块、全套数据结构迁移还是全工程接口契约审计,均能保持完整因果注意力闭环。

上下文窗长 128,000
APPLICATION SCENARIOS

高维攻坚场景 · 从代码重构到实战落地

当面对千头万绪的庞大遗留单体工程与复杂边界约束时,DeepSeek 显式思维链能为核心架构决策提供坚实论据支撑。

系统级代码重构

针对数万行遗留复杂工程进行依赖解耦,自动理顺全局调用图谱,输出高可靠性单元测试与不可变数据契约。

Codeforces 竞赛评分: 2029 (Expert)

奥数与形式化证明

在 AIME 及高等数学竞赛题中展现自主反思链,分步列出引理假设、反例推演并最终完成形式化数学推导。

AIME 2024 Pass@1: 79.8%

跨域法务并购审查

一次性吞吐数百页对赌协议与尽调底稿,精准识别隐性对冲风险、排他性条款冲突及合规敞口。

多文档长程交叉核验闭环

多因子量化策略回测

阅读异构高频行情数据与财报因子,自主编写事件驱动仿真逻辑并完成过拟合惩罚性回溯。

支持 Python/C++ 双向代码仿真

自主多步智能体 (Agent)

配合外部 API、Shell 终端与数据库检索,执行自主规划、中间环境反馈感知与错误自愈长任务。

SWE-bench Verified 达标率领先

私有化离线集群部署

提供全套量化蒸馏模型权重(1.5B ~ 70B),适配国产算力卡与单卡端侧工作站,确保代码资产物理不出域。

GGUF / vLLM / SGLang 原生支持
MODEL RACK & MATRIX

官方基座模型矩阵与算力选型

横向机架标准化阵列,以明确技术参数与清晰透明资费,满足从日常在线探索到企业级深度代码重构生产调用的严苛需求。
STANDARD 通用主力 DeepSeek-V3 通用高吞吐基座模型
架构体系 MLA + 无损 MoE
首字延迟 < 200 ms
工程综合表现 MMLU 88.5%
输出资费 ¥0.28 / 百万
¥0.07 / 1M Tokens 输入
查看标准接口文档 →
EDGE 蒸馏轻量端侧 DeepSeek-R1-Distill 1.5B ~ 70B 开源蒸馏系列
规格分支 Qwen / Llama 骨架
单卡吞吐 120+ Tokens/s
部署方案 Ollama / vLLM
商用许可 MIT 完全免费
开源免费 / 商业无限制
获取本地开源权重 →
DeepSeek api开放平台接入配置流程图
API_GATEWAY // OPENAI_PROTOCOL_COMPATIBLE
STEP BY STEP INTEGRATION

开发者代码重构接入三部曲

01

注册并创建 API Key 凭据

登录 DeepSeek api开放平台控制台,一键生成带有白名单与速率限制策略的高权限凭据密钥。

02

调整 BaseURL 与认证请求头

接口完全兼容 OpenAI SDK 协议规范,只需切换请求端点至官方安全集群,无须修改既有代码分析流水线。

03

开启 64-Token 前缀缓存与流式推送

针对全工程架构约束 Prompt 自动完成硬盘级对齐缓存,开启 stream 模式实时回传重构逻辑与思维链。

OFFICIAL ACCESS CHANNELS

官方通道矩阵 · 随时随处直达

围绕 DeepSeek 官方网页版入口与开发者生态,构筑稳定无缝的多终端连接通路。

DeepSeek 网页版入口 (Web Terminal)

零门槛免安装,随时在桌面端和移动浏览器开启 R1 深度对话与代码重构。

直接进入网页版 →

DeepSeek API 开放平台 (Developer Gateway)

为高并发企业业务提供 99.9% 稳定 SLA 承诺,支持批量离线工程分析。

开发者控制台 →

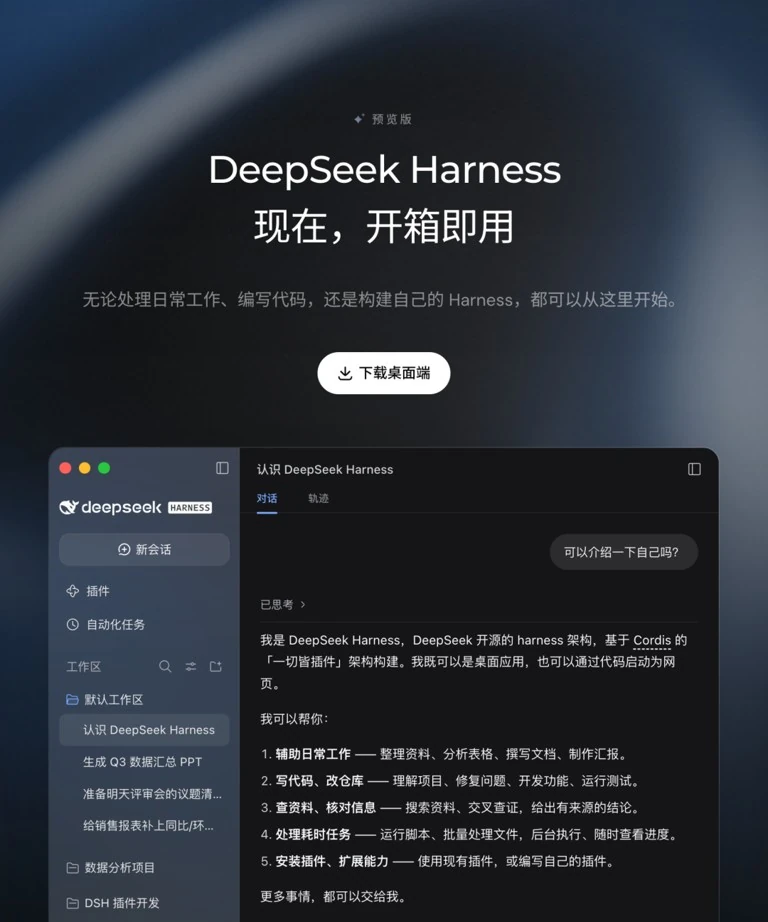
DeepSeek Harness 自动化评测 (Evaluation Sandbox)

开源独立基准套件,支持在内网环境进行语法树断言校验与一致性复现。

了解双盲复现 →
DeepSeek 网页版入口多终端适配与代码阅读界面
PORTAL_MATRIX // UNIFIED_AUTHENTICATION
PROVEN PERFORMANCE

硬核数据量化实测证明

所有指标来自官方集群常态化压测与第三方权威学术榜单独立复现,不掺水、不设防、全透明。

99.8%
API 线上可用率 SLA
多机房容灾自动故障倒换
¥0.14
百万元 Token 缓存资费
行业首创硬盘前缀命中减免
128K
显式推理长上下文
全长范围注意力不衰减
60+
单并发稳定输出 QPS
MLA 显存优化带来高吞吐
进入网页版入口
DEEPSEEK_HARNESS_REFACTOR_EVAL.CLI
PYTHON 3.11
# 克隆官方独立开源评测框架 Harness
$ git clone https://local-repo/deepseek-ai/DeepSeek-Harness.git
$ cd DeepSeek-Harness && pip install -r requirements.txt

# 执行 AST 语法树断言与代码重构等价性沙箱测试
$ python -m harness.evaluate \
    --model deepseek-ai/DeepSeek-R1 \
    --tasks codeforces,ast_refactor_invariants \
    --strict_ast_check --num_fewshot 0

[HARNESS] Loaded 500 refactoring invariants with strict AST parity
[HARNESS] Evaluation Pass@1: 79.8% (Exact Invariant Verified)
>>> All reasoning chain invariants passed successfully.
REPRODUCIBLE RESEARCH

DeepSeek Harness 闭环评测体系

严格确定性与语法树断言校验

拒绝模糊提示词评分。Harness 采用抽象语法树(AST)与形式化编译器检查进行双重断言,杜绝模型产生幻觉式蒙对现象。

完全解耦防污染与离线双盲机制

评测集采用动态加盐变量机制,严密阻断题目被训练语料预先见过的“数据污染”假阳性问题,捍卫严谨科学伦理。

FREQUENTLY ASKED QUESTIONS

常见深度求索问答专栏

关于 DeepSeek 官网与网页版入口的核心疑问解答,点击折叠栏展开查看详情。

这是通过大规模纯强化学习(Pure RL)在编译器与逻辑正确性奖励函数引导下自发涌现的认知特征。模型在推演重构方案的过程中,自发学会了理顺依赖环路、假设边界断言、在发现潜在死锁时自动回溯,从而展现出透明、清晰的显式逻辑因果链,彻底告别盲盒式黑盒猜代码。
直接点击导航栏的「网页版入口」或页面下方的「进入网页版入口」按钮,即可在现代浏览器中立即唤起对话工作区。系统支持在线调整“深度思考”开关,无需繁琐本地配置环境,支持长达 128,000 Tokens 的长文档连续上下文交互。
在协议层完全实现 100% 格式无缝兼容。开发者仅需将环境变量 OPENAI_BASE_URL 替换为官方代理节点,并换用对应 model="deepseek-reasoner" 或 model="deepseek-chat" 即可开箱即用。同时,平台自带 64-Token 整数倍前缀缓存优化,大幅节约多轮长工程调用的开销。
对于单机轻量化调试场景,推荐选用 DeepSeek-R1-Distill-Qwen-7B / 14B / 32B 系列蒸馏版本,在单张 24GB 显存消费级显卡(如 RTX 4090)上配合 vLLM 或 Ollama 的 4-bit 量化即可流畅运行;若需部署 671B 完整 MoE 满血版集群,建议选用 8x80GB SXM5 拓扑环境以承载全精度高吞吐推理。
LATEST INSIGHTS & UPDATES

官方技术动态与研究简报

跟踪底层架构前沿演进,见证开源世界代码推理能力的持续突破。

DeepSeek-R1 正式入驻 API 开放平台并支持显式思维链回传

官方推出 deepseek-reasoner 独立端点,在流式回传中分离 reasoning_content,便于客户端精准渲染思考折叠块。

DeepSeek Harness 开源版本上线并支持 AST 重构等价性离线评测

提供完整的语法树检查与确定性数学答案比对沙箱,方便全球开发者在本地环境中独立验证公布指标。

MLA 潜在注意力机制与前缀缓存技术白皮书深度解读

详述 64-Token 整数倍固化前缀缓存在长上下文多轮问答中的显存节省机制与经济效益测算公式。